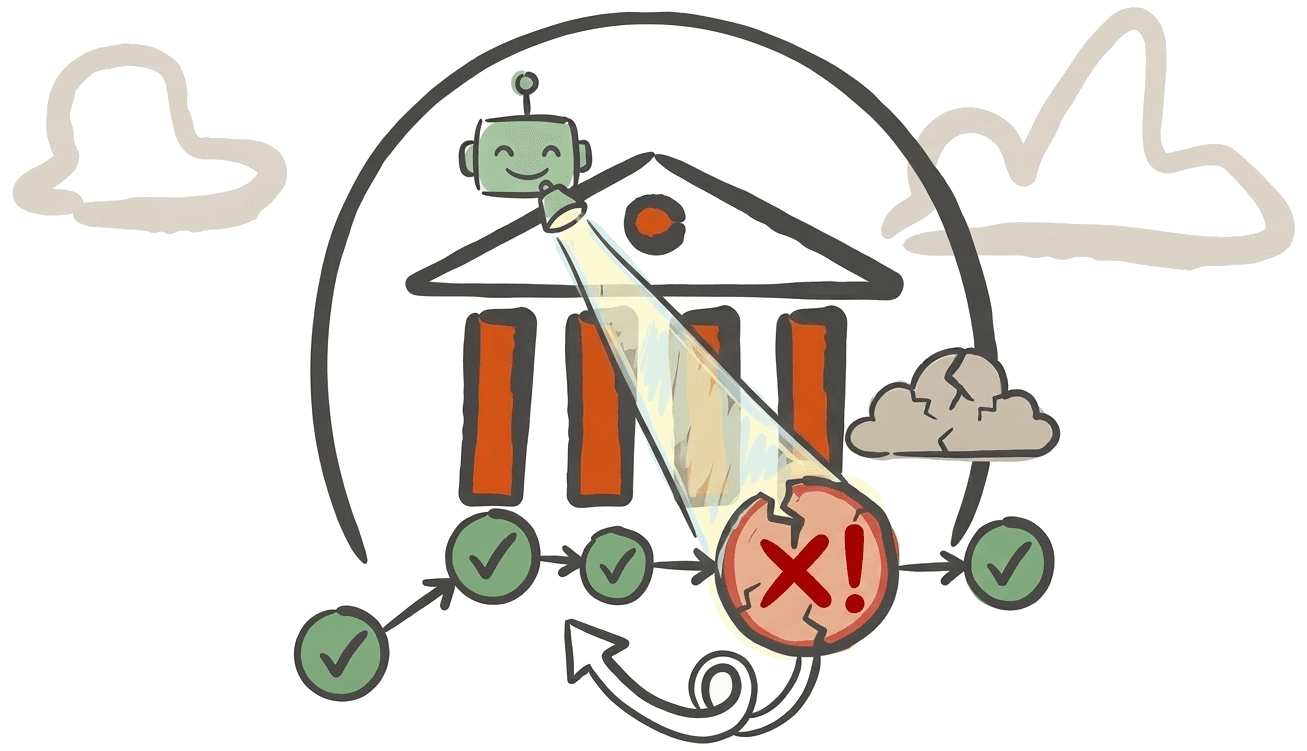
Tus dashboards están en verde.Tu negocio no.
Greenblind vigila tus flujos de negocio — pagos, registros, aprovisionamiento — y te avisa en el momento en que algo esperado deja de ocurrir. Sin dashboards que vigilar.
Del silencio a la resolución
Detectar
Los eventos esperados dejan de llegar. Notamos el silencio que ningún dashboard muestra.
Entender
Mapeamos el flujo y señalamos el paso exacto que falló.
Diagnosticar
Eventos, deploys y errores se correlacionan en una causa raíz probable.
Recuperar
Reproduce o pausa de forma segura — solo con tu aprobación explícita.
La caída sin mensaje de error
Tu servidor responde 200. Tus logs están limpios. Tu rastreador de errores está en silencio. Y anoche tu webhook de pagos dejó de entregarse sin avisar. Lo descubriste seis horas después — por un mensaje de un cliente.
- Cron jobs que se ejecutan pero procesan cero registros
- Webhooks que se entregan pero el downstream nunca los maneja
- Pagos que se completan pero las cuentas nunca se activan
- Ingresos que caen en silencio a cero
Por qué las herramientas actuales no lo ven
Monitores de uptime
Comprueban si un servidor responde con un 200. Nunca miran lo que tu negocio realmente hizo.
Rastreadores de errores
Esperan una excepción que nunca llega. Un fallo silencioso no lanza nada.
Analytics
Muestran los datos que llegan. Cero eventos se ve idéntico a una tarde tranquila.
El silencio es el modo de fallo que nadie vigila. Construimos Greenblind exactamente para eso.
Cómo funciona
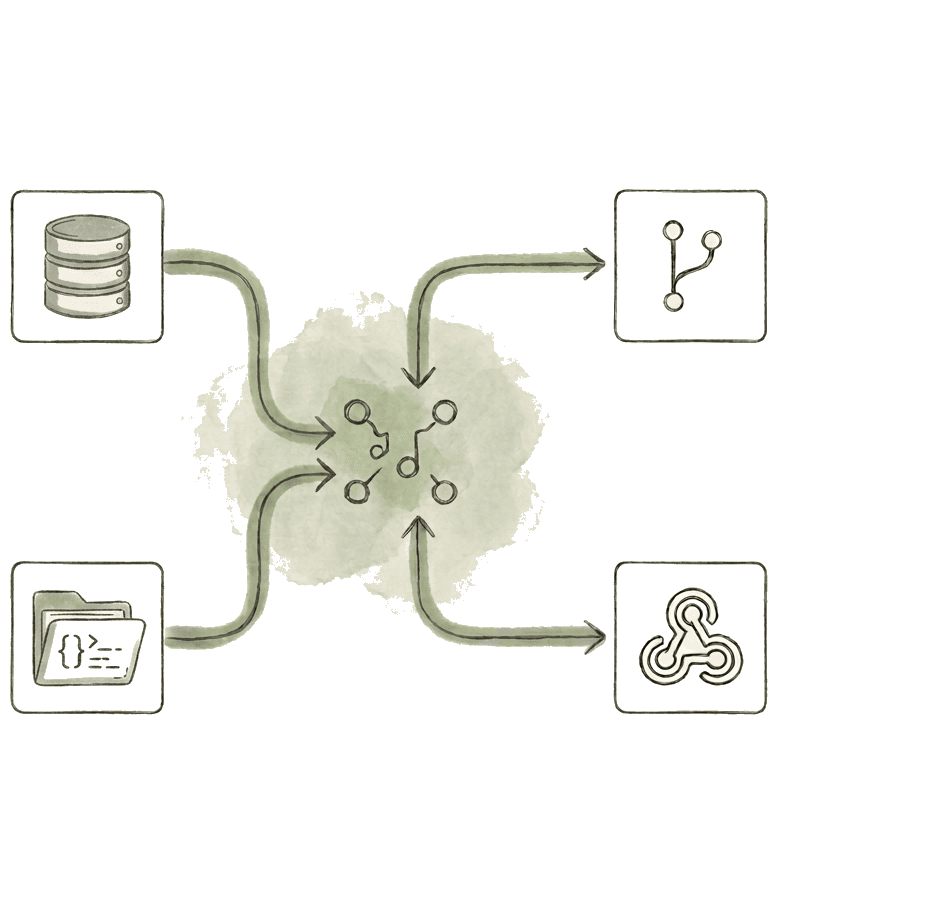
Conecta
Enlaza Stripe, GitHub o cualquier webhook genérico. Sin SDK, sin YAML, sin infraestructura.
Aprende
Greenblind aprende cómo es lo normal para cada evento, sin umbrales que ajustar.
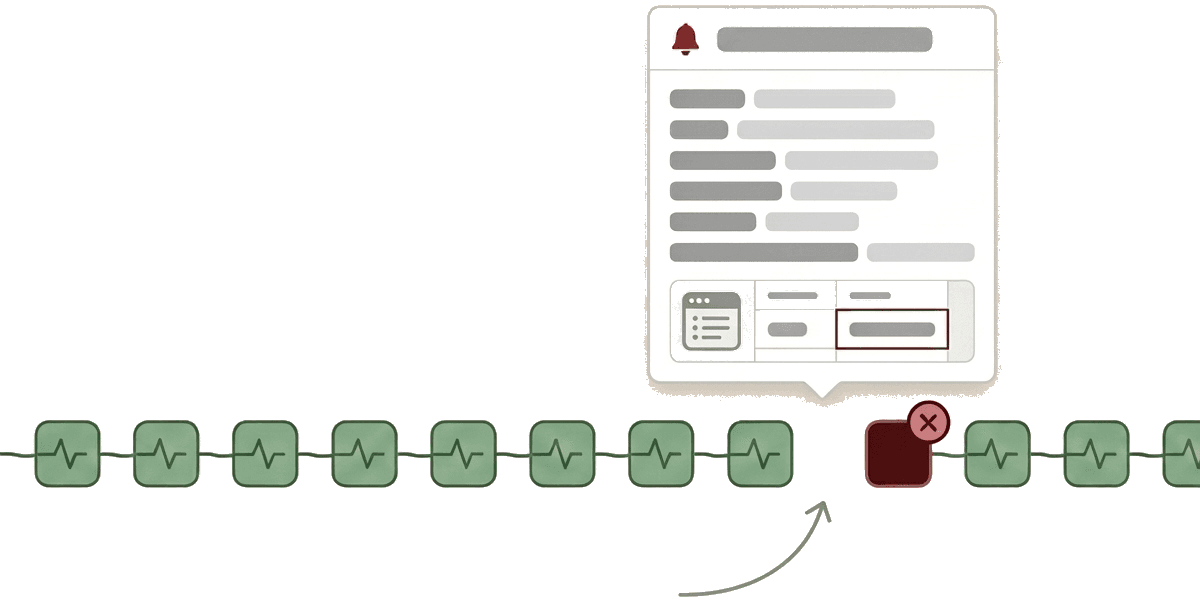
Recibe alertas
En el momento en que un evento esperado deja de llegar, lo sabes — con evidencia, no ruido.
No solo qué falló — por qué
Cada incidente incluye la evidencia que lo respalda, para que arregles la causa, no el síntoma.
100 clientes afectados
Causa raíz probable: Order Service a Database
- Stripe sano — 100 pagos recibidos
- Webhook sano — 100 entregados
- Creación de pedidos falló — 0 de 100 con éxito
- El deploy llegó 3 minutos antes del incidente
Recupera, con seguridad
Una vez arreglada la causa, reproduce los eventos fallidos con un clic. Nada toca producción sin tu permiso.
Detectar, Diagnosticar, Recomendar, Aprobación humana, Acción
Lo que obtienes
Alertas de silencio
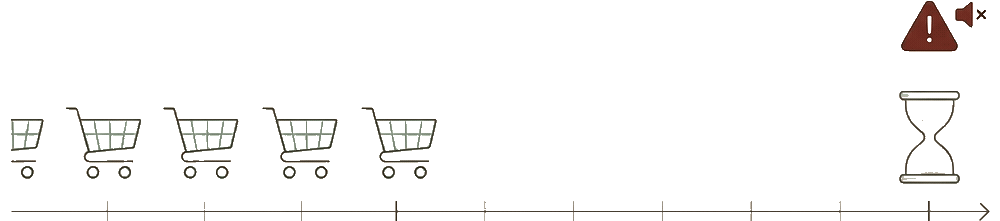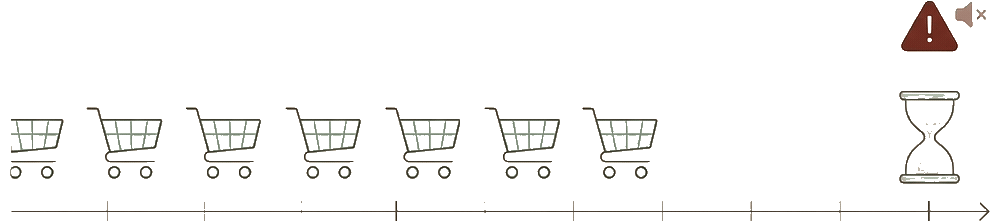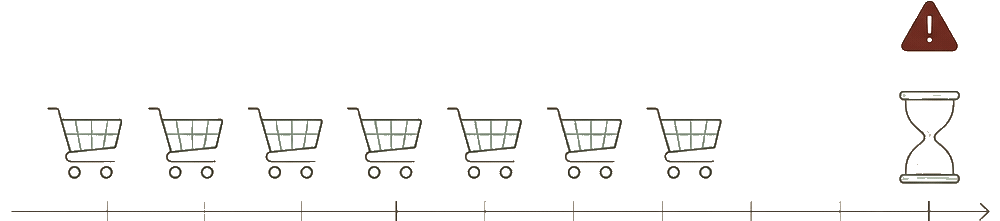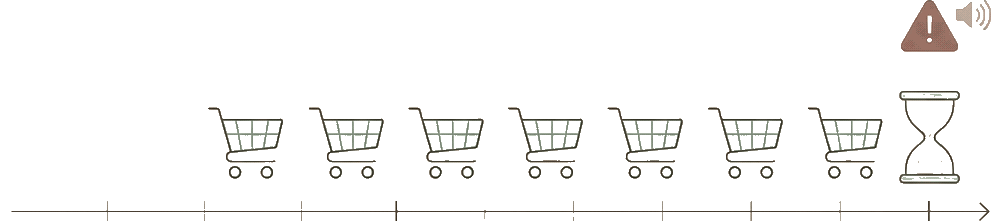
Sin nuevo pago en 6 horas. La ausencia de un evento esperado es la alerta que otras herramientas no te dan.
Flujos rotos
14 checkouts, 0 completados. Detecta procesos de varios pasos que empiezan pero nunca terminan.
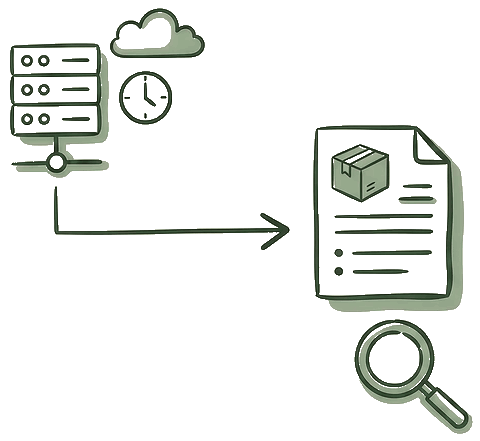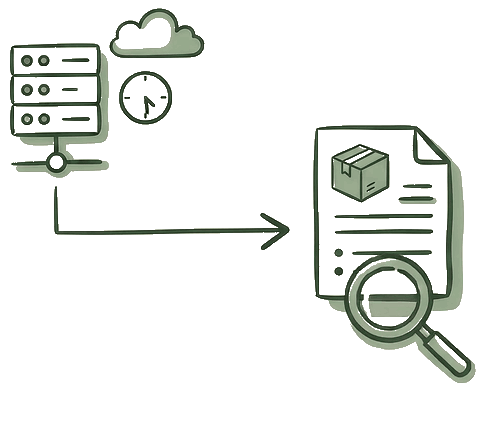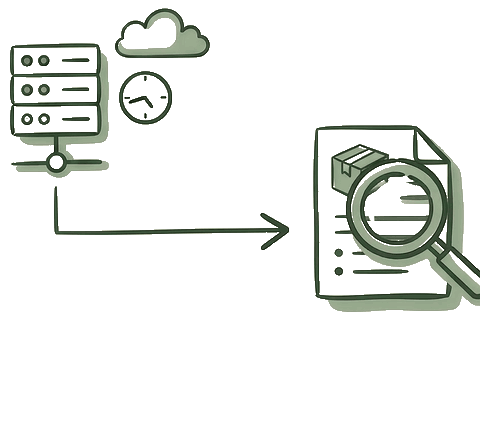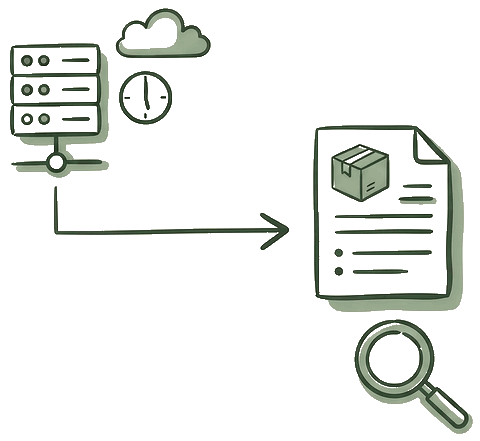
Diagnóstico en una línea
La activación se detuvo en Order Service. El deploy llegó 3 minutos antes. Claro y respaldado por evidencia.
Correlación de deploys
Vinculamos el fallo con el cambio que lo causó, para que arregles la causa — no el síntoma.
Vigila también tus agentes de IA
Los agentes entran en bucle, se estancan o queman tokens mientras todos los dashboards siguen en verde. Detectamos la tarea que nunca terminó.
Agente atascado — Reembolso #123
Paso: Actualizar CRM · 7 reintentos · 8m · causa probable: CRM API 429
Empieza sin código. Profundiza cuando lo necesites.
Sin código
Conecta Stripe, GitHub o cualquier webhook. Detecta y alerta en minutos.
SDK
Emite eventos de negocio desde tu app para una cobertura total del flujo.
Observabilidad profunda
Logs, métricas, trazas y deploys — para diagnóstico y recuperación segura.
IA donde importa — no en todas partes
Un motor determinista gestiona cada evento. La IA solo decide donde hay ambigüedad real.
Motor determinista
Ingesta, conteo, timeouts, secuencias y umbrales.
Modelo de decisión pequeño
¿Es un incidente? ¿Qué gravedad? ¿Es seguro reintentar?
LLM grande
Explicación de causa raíz e investigación para los casos más difíciles.
Fundadores reales, fallos silenciosos reales
“El año pasado se fue una cuenta grande y el dashboard estuvo en verde todo el tiempo.”
“Su envío de facturas llevaba horas en verde sin enviar nada, hasta que un cliente preguntó dónde estaba la factura.”
“El evento de registro se renombró en GTM durante un rediseño. GA4 se vio bien durante seis semanas.”
A dónde vamos
Una capa de fiabilidad de IA para SaaS y apps AI-native
Entendemos eventos, flujos, estado del negocio, logs, métricas, deploys y agentes — y los convertimos en detección, diagnóstico y recuperación.
Preguntas
Tu negocio está funcionando ahora mismo. ¿Estás mirando?
Consigue acceso anticipado y sé el primero en saber cuando Greenblind detecte un fallo silencioso en tu stack.
Cómo funciona