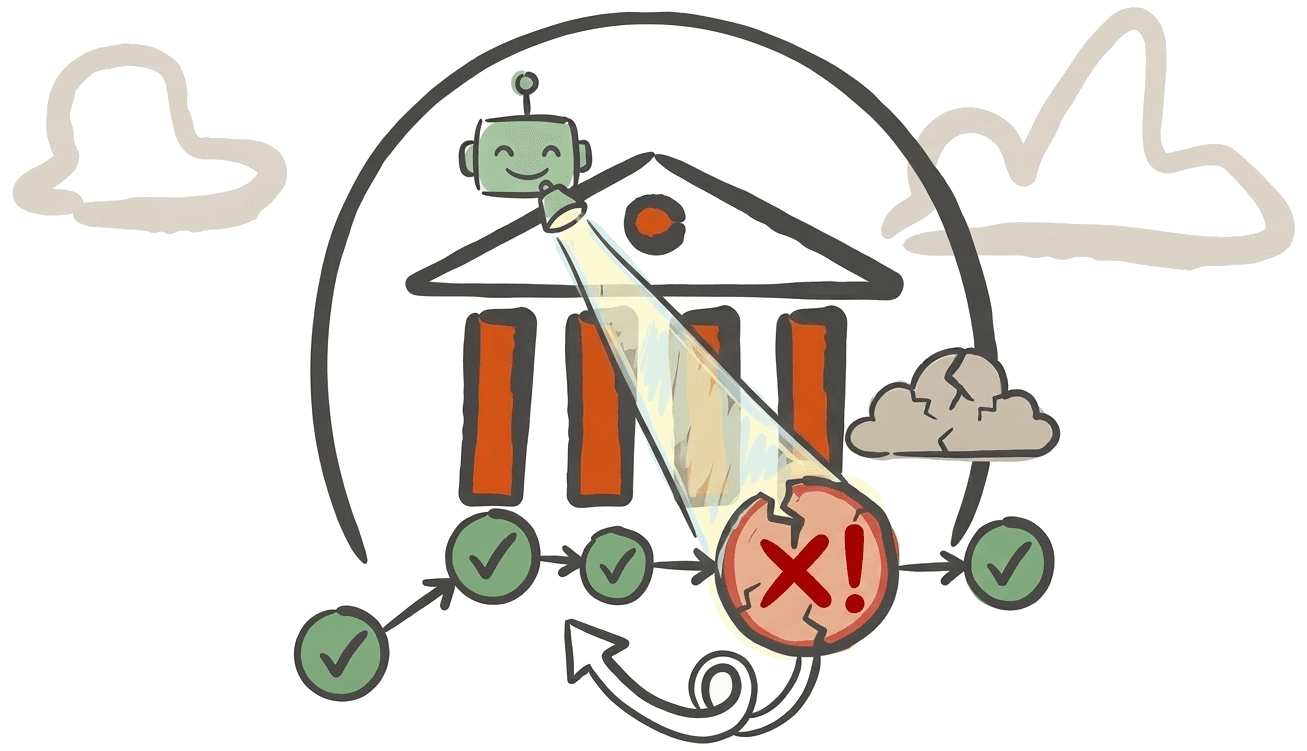
Deine Dashboards sind grün.Dein Geschäft nicht.
Greenblind überwacht deine Geschäftsprozesse — Zahlungen, Anmeldungen, Bereitstellung — und alarmiert dich, sobald etwas Erwartetes ausbleibt. Keine Dashboards, die du beobachten musst.
Vom Schweigen zur Lösung
Erkennen
Erwartete Events bleiben aus. Wir bemerken die Stille, die kein Dashboard zeigt.
Verstehen
Wir kartieren den Workflow und identifizieren den genauen Schritt, der brach.
Diagnostizieren
Events, Deploys und Fehler werden zu einer wahrscheinlichen Grundursache korreliert.
Wiederherstellen
Sicher wiederholen oder pausieren — nur mit deiner ausdrücklichen Zustimmung.
Der Ausfall ohne Fehlermeldung
Dein Server antwortet mit 200. Deine Logs sind sauber. Dein Fehler-Tracker ist still. Und letzte Nacht hat dein Zahlungs-Webhook still aufgehört zuzustellen. Du hast es sechs Stunden später erfahren — aus einer Kunden-DM.
- Cron Jobs, die laufen, aber null Datensätze verarbeiten
- Webhooks, die zugestellt, aber downstream nie verarbeitet werden
- Zahlungen, die durchgehen, aber Konten nie aktiviert werden
- Umsatz, der still auf null fällt
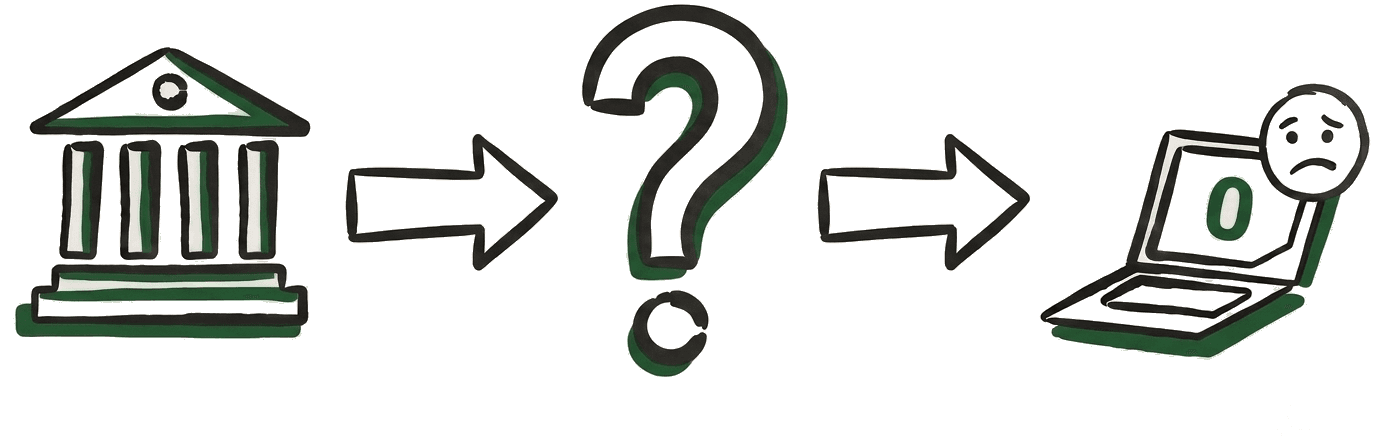
Warum bestehende Tools es übersehen
Uptime-Monitore
Prüfen, ob ein Server mit 200 antwortet. Sie sehen nie, was dein Geschäft tatsächlich getan hat.
Fehler-Tracker
Warten auf eine Ausnahme, die nie kommt. Ein stiller Ausfall wirft nichts.
Analytics
Zeigen die Daten, die ankommen. Null Events sieht aus wie ein ruhiger Nachmittag.
Stille ist der Fehlermodus, den niemand beobachtet. Genau dafür haben wir Greenblind gebaut.
So funktioniert's
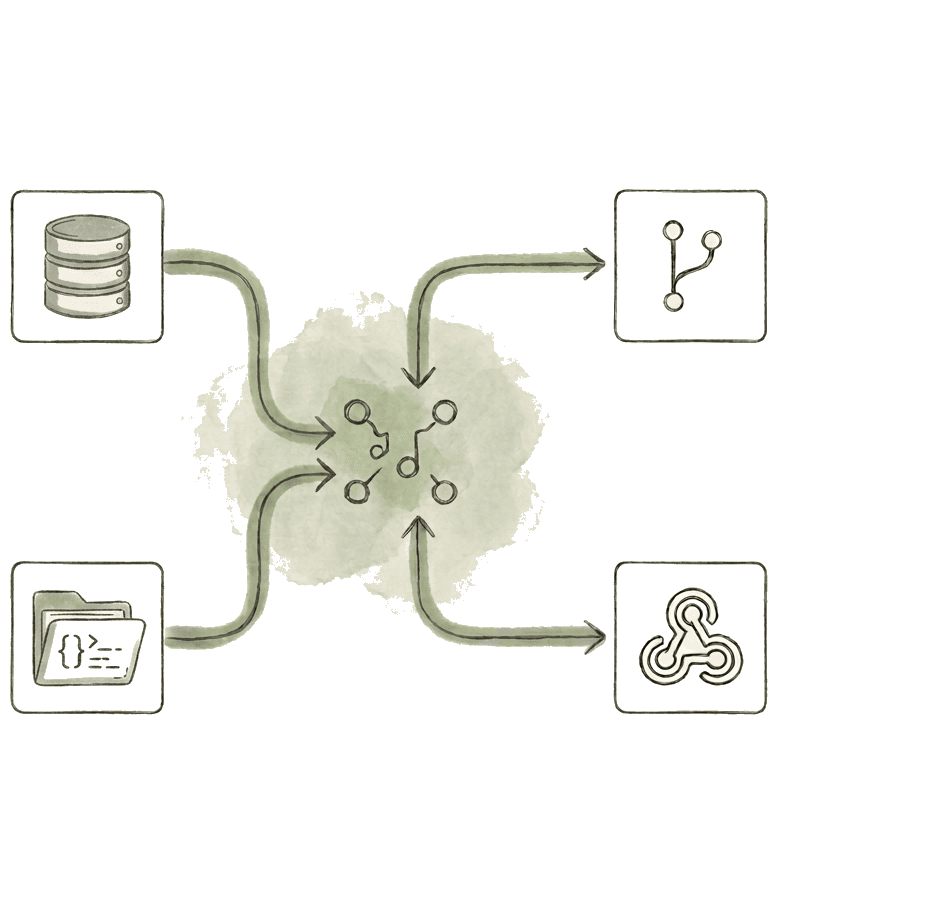
Verbinden
Verbinde Stripe, GitHub oder einen generischen Webhook. Kein SDK, kein YAML, keine Infrastruktur.
Lernen
Greenblind lernt, was für jedes Event normal ist — ohne Schwellenwerte einzustellen.
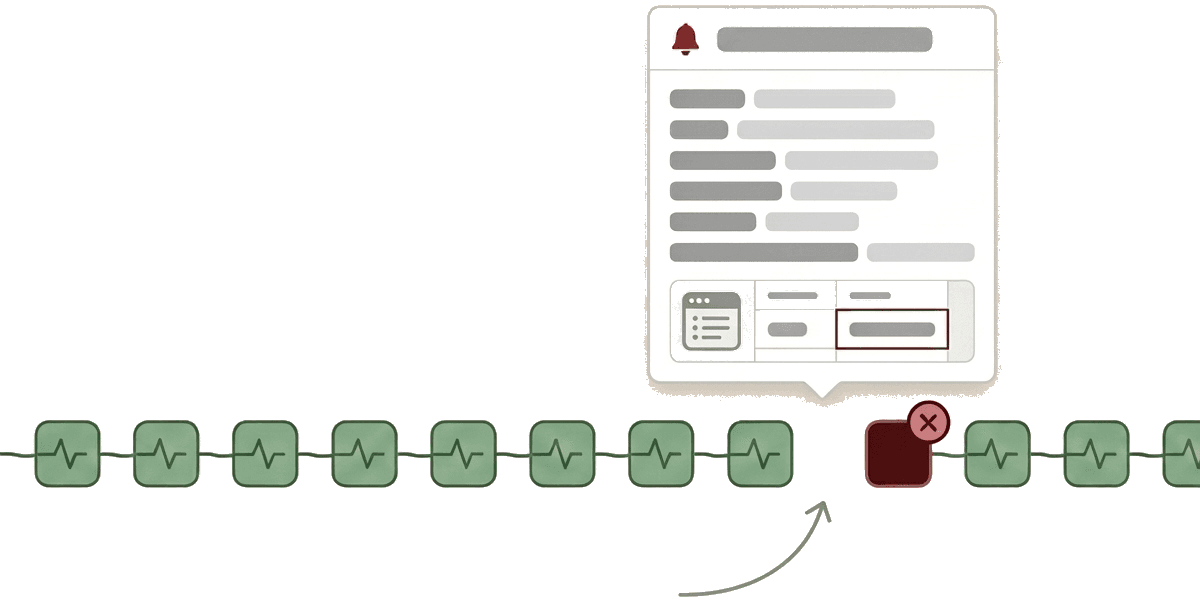
Alarmiert werden
Sobald ein erwartetes Event ausbleibt, weißt du es — mit Belegen, nicht mit Rauschen.
Nicht nur was brach — sondern warum
Jeder Vorfall enthält die Belege dahinter, damit du die Ursache behebst, nicht das Symptom.
100 Kunden betroffen
Wahrscheinliche Grundursache: Order Service zu Database
- Stripe gesund — 100 Zahlungen empfangen
- Webhook gesund — 100 zugestellt
- Bestellerstellung fehlgeschlagen — 0 von 100 erfolgreich
- Deploy erfolgte 3 Minuten vor dem Vorfall
Wiederherstellen, sicher
Sobald die Ursache behoben ist, spiele fehlgeschlagene Events mit einem Klick erneut ab. Nichts berührt die Produktion ohne deine Erlaubnis.
Erkennen, Diagnostizieren, Empfehlen, Menschliche Freigabe, Aktion
Was du bekommst
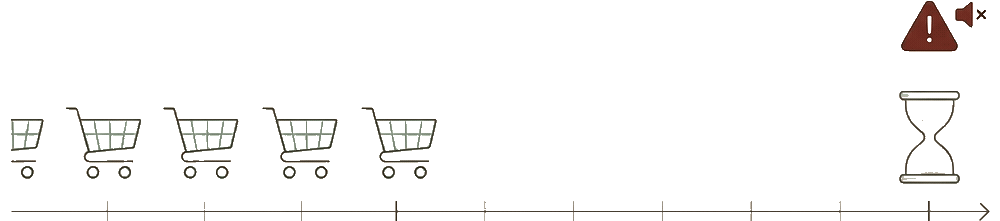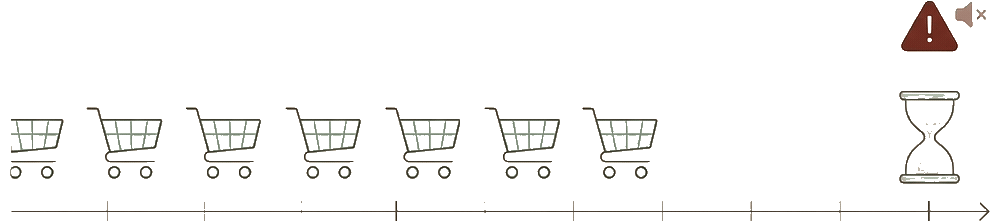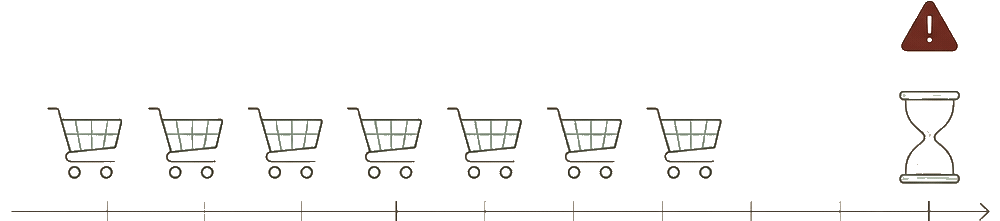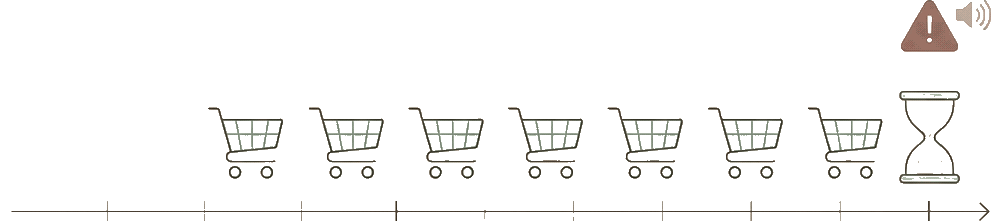
Stille-Alarme
Seit 6 Stunden keine neue Zahlung. Das Ausbleiben eines erwarteten Events ist der Alarm, den andere Tools nicht liefern.
Kaputte Abläufe
14 Checkouts, 0 abgeschlossen. Erkenne mehrstufige Prozesse, die starten, aber nie enden.
Diagnose in einer Zeile
Die Aktivierung blieb beim Order Service stehen. Das Deployment kam 3 Minuten vorher. Klar und belegt.
Deployment-Korrelation
Wir verknüpfen den Ausfall mit der Änderung, die ihn verursacht hat — damit du die Ursache behebst, nicht das Symptom.
Überwache auch deine KI-Agenten
Agenten loopen, stocken oder verbrennen Tokens, während jedes Dashboard grün bleibt. Wir erkennen die Aufgabe, die nie fertig wurde.
Agent hängt — Rückerstattung #123
Schritt: CRM aktualisieren · 7 Versuche · 8 Min. · wahrscheinliche Ursache: CRM API 429
Starte ohne Code. Geh tief, wenn nötig.
Ohne Code
Verbinde Stripe, GitHub oder jeden beliebigen Webhook. Erkennen und alarmieren in Minuten.
SDK
Sende Business-Events aus deiner App für volle Workflow-Abdeckung.
Tiefe Observability
Logs, Metriken, Traces und Deploys — für Diagnose und sichere Wiederherstellung.
KI, wo sie zählt — nicht überall
Eine deterministische Engine verarbeitet jedes Event. KI entscheidet nur, wo echte Mehrdeutigkeit besteht.
Deterministische Engine
Ingestion, Zählung, Timeouts, Sequenzen und Schwellenwerte.
Kleines Entscheidungsmodell
Ist das ein Vorfall? Wie schwer? Ist ein Wiederholen sicher?
Großes LLM
Grundursachen-Erklärung und Untersuchung für die schwierigsten Fälle.
Echte Gründer, echte stille Ausfälle
“Letztes Jahr ist ein großer Account gegangen, und das Dashboard war die ganze Zeit grün.”
“Sein Rechnungslauf war jede Stunde grün und hat nichts versendet, bis ein Kunde fragte, wo die Rechnung bleibt.”
“Das Signup-Event wurde bei einem Redesign in GTM umbenannt. GA4 sah sechs Wochen lang gut aus.”
Wohin wir gehen
Eine KI-Zuverlässigkeitsschicht für SaaS und AI-native Apps
Wir verstehen Events, Workflows, Geschäftszustand, Logs, Metriken, Deploys und Agenten — und machen daraus Erkennung, Diagnose und Wiederherstellung.
Fragen
Dein Geschäft läuft gerade jetzt. Schaust du zu?
Sichere dir frühen Zugang und erfahre als Erster, wenn Greenblind einen stillen Ausfall in deinem Stack erkennt.
So funktioniert's